rCore Labs
TL;DR
这篇博客用于记录探索rCore kernel的设计哲学和学习遇到值得思考的内容
对这个实验感兴趣的原因也是Rust是第一个走进Linux项目的现代编程语言(虽然目前大部分仍在驱动程序环节)
对于内核本身,现代编程语言相较于C,也是有很多需要重新设计和考虑的情况
rCore vs xv6
由于语言的不同,两者在设计思路上也会有区别
自定义section
自定义sections绝对是编译/构建工程中的一个绝佳方案,它可以让构建过程脱离对于Makefile的依赖,而Rust的理念是通过Cargo来自动化构建
过去对于Makefile强依赖的原因是地址顺序,由于kernel离开ROM的时候,pc需要刚好在0x80000000上执行_entry符号中的代码
这也就意味着在链接的时候,需要在Makefile和链接器脚本进行配合
(如今的xv6已经通过优化链接脚本脱离了对于Makefile的依赖)
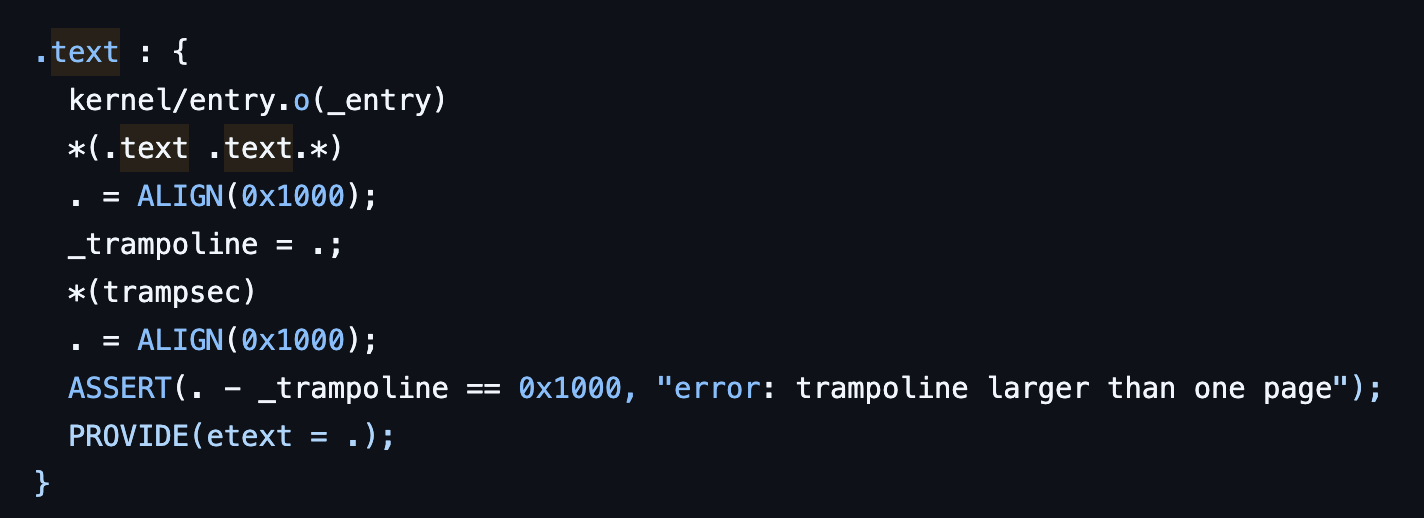
可以看到已经在kernel.ld中显式说明了要先处理entry.o,并将其放置到0x80000000上
实现了解耦
但是如果在ld脚本中没有显示说明,使用了通用的.text写法,例如:
.text : {
    *(.text .text.*)
}
这样就会依赖Makefile中传入.o文件的顺序
同时我们可以自己实践查看Rust是如何将函数编译时分为不同section的
#[inline(never)] // disable inline
pub fn foo() {
    println!("Hello from foo!");
}

#[inline(never)]
pub fn bar() {
    println!("Hello from bar!");
}

fn main() {
    foo();
    bar();
}
rustc --emit=obj main.rs
objdump -h main.o
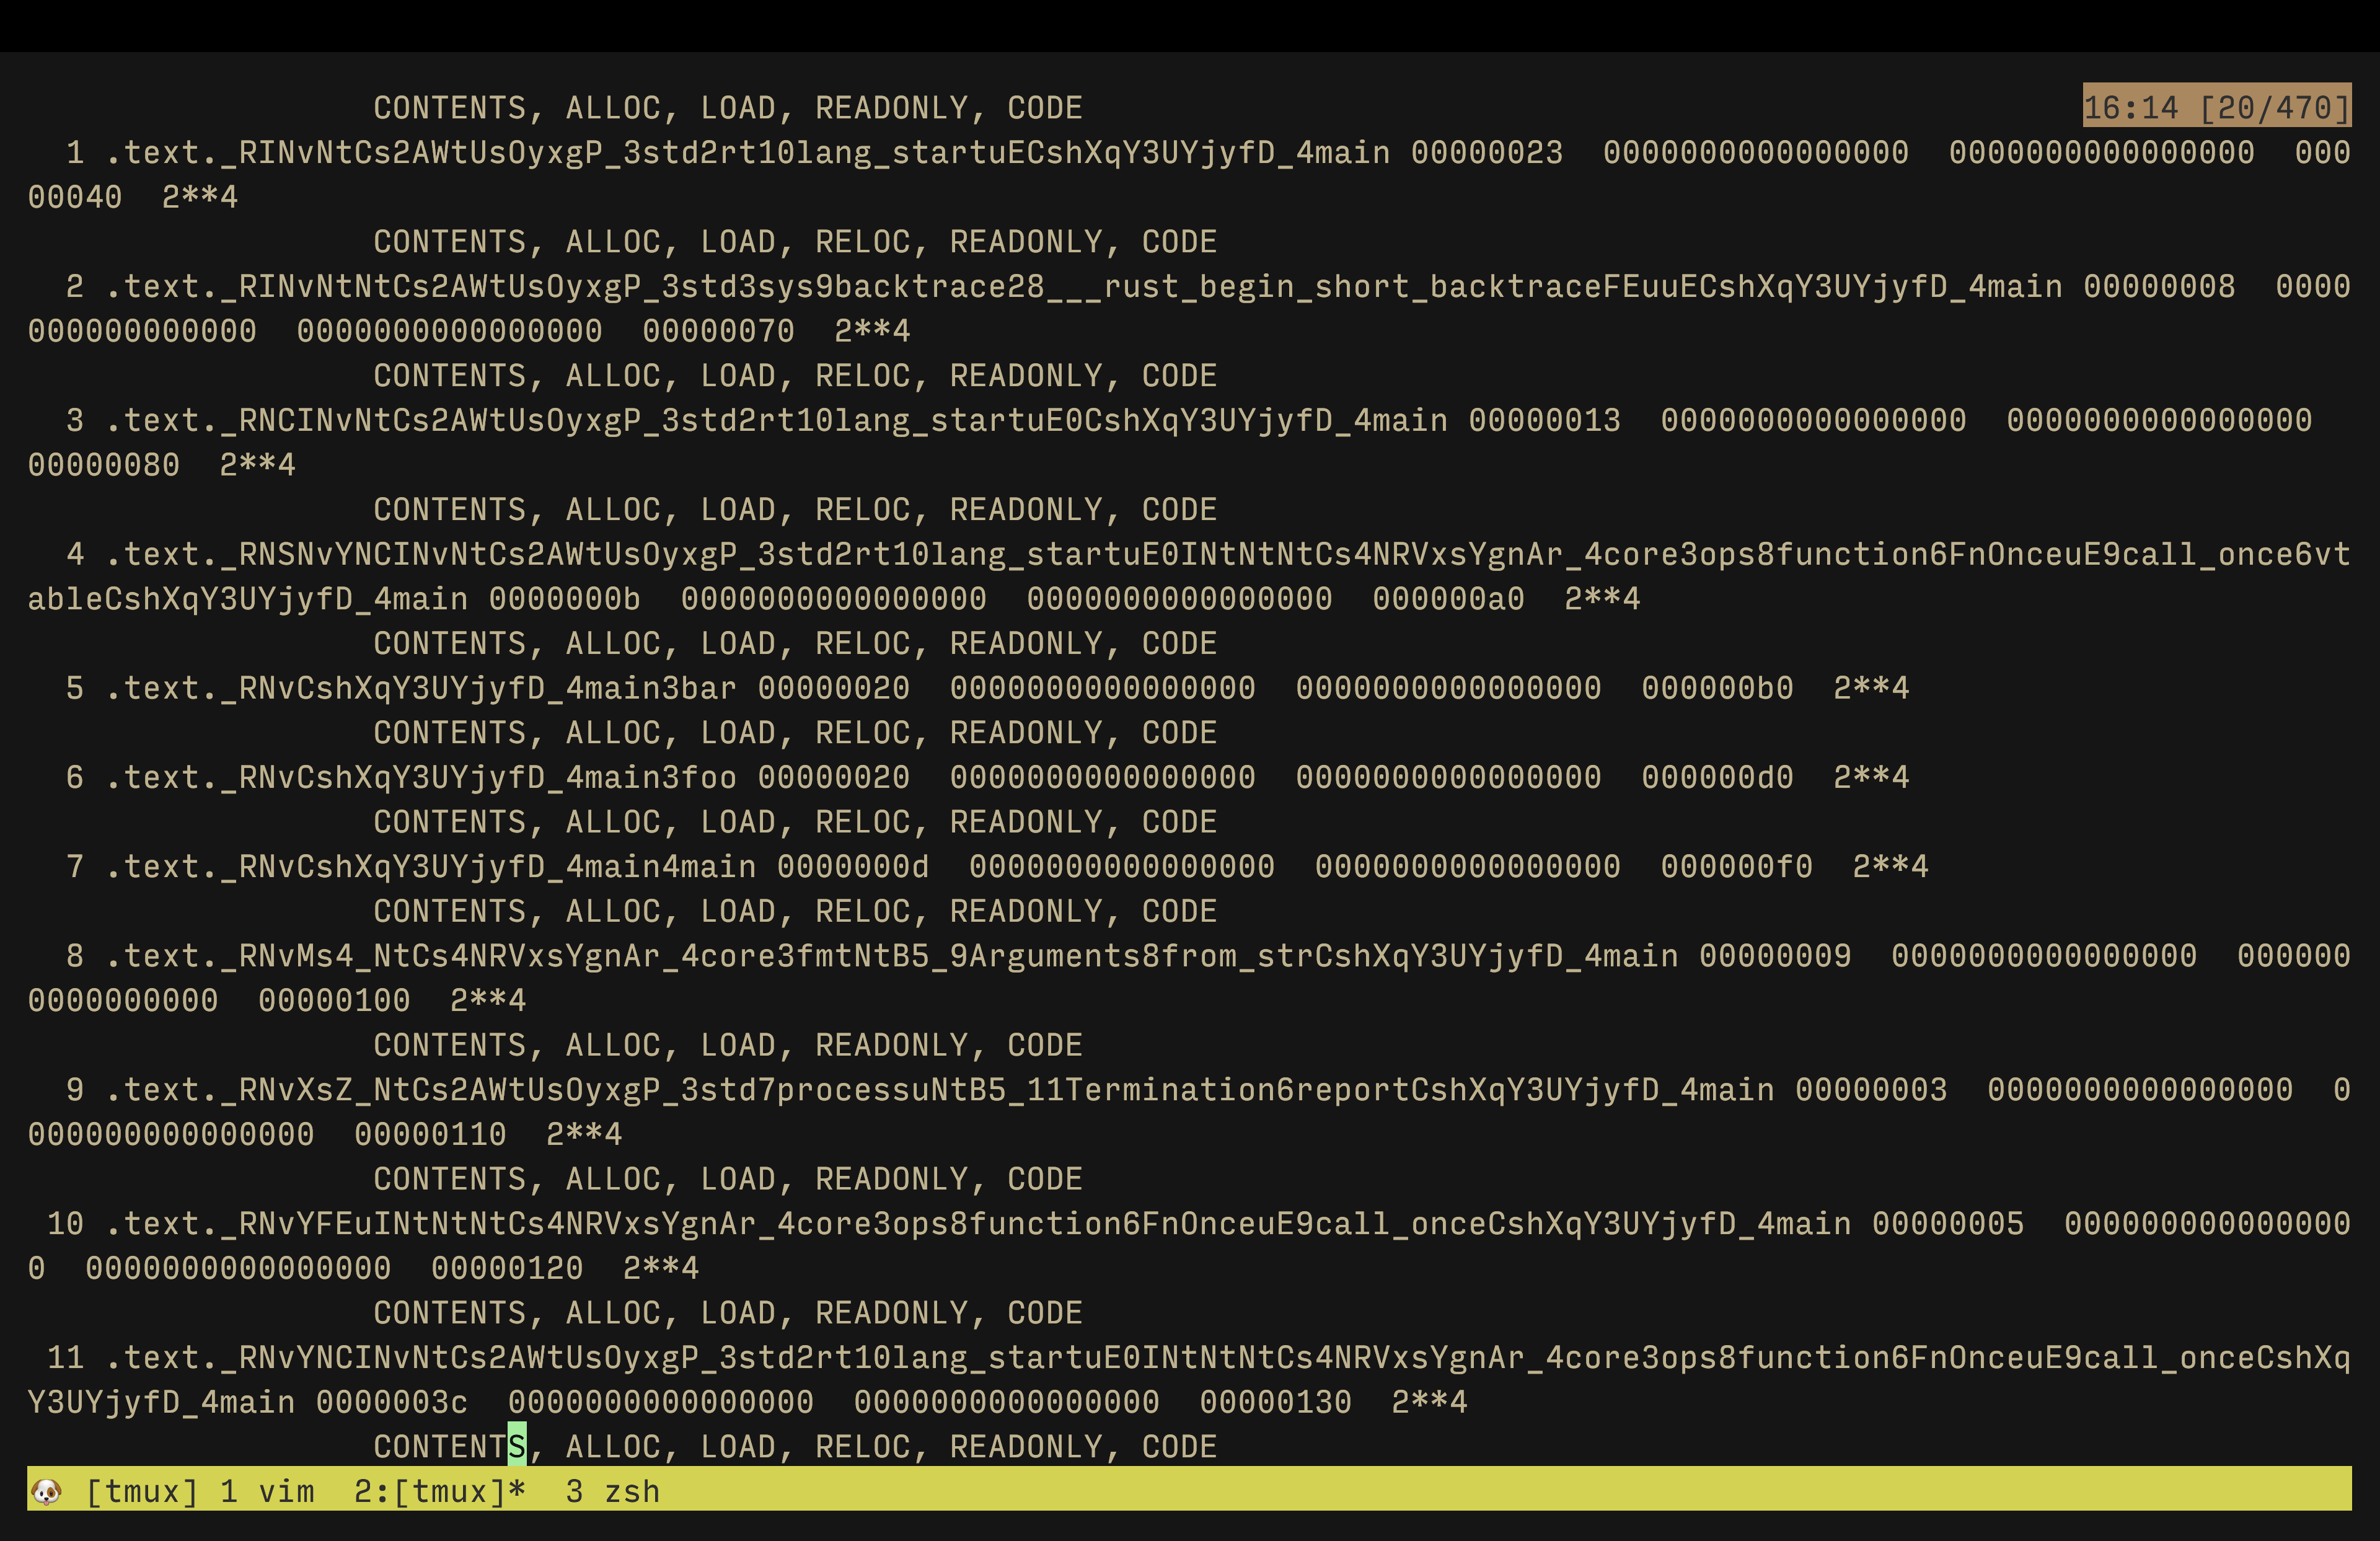
这样就可以看到对应的section
总结优势:
构建工具解耦,不依赖Unix Makefile
可以适配LLVM + LTO(链接时优化)
符合Rust哲学 -> 显示优于隐式
LLVM and LTO
这个可以单开一个进行讲解
tsoding曾聊到stb库,也就是单头文件库的概念
很多人在这里曾表示过怀疑,认为这种情况只能适用于小型库,但实际上,它可以扩展为任意复杂度
sqlite值得被称为世界上最伟大的数据库之一,它提供了amalgamation版本
将所有文件合并为两个.c文件
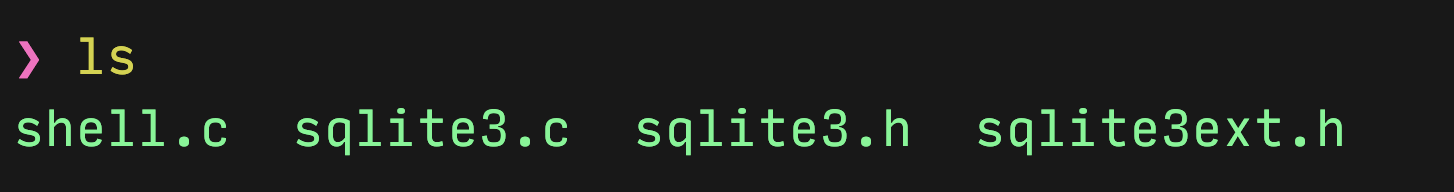
这样做的好处是可以让编译器根据上下文,最大限度地利用编译器优化,也可以实现单头文件调用sqlite api
当然缺点是编译速度相对慢
llvm在这里同理,当编译器生成ir后,llvm将所有文件的ir合并在一起,这样就实现了这样的效果
如今结合LTO,使用自定义section可以实现跨模块函数内联, 全程序死代码消除, 虚函数去虚拟化
